趣味で表面メッシュ(sparse graph)のpartitioningがしたくなったので、GPUで書けるかつ実装しやすそうなものを試してみる。
初めて実装したタイプの分野かつCUDA下手くそマンなので、メモ書き程度に実装ポイントをまとめておく。
Lee et al. 2024のこちら、
G-kway: Multilevel GPU-Accelerated k-way Graph Partitioner
https://dl.acm.org/doi/10.1145/3649329.3656238
私の実装はMITライセンスでGitHubにおいてある。
別に優れた実装ではないし、論文で書かれていたいくつかのlow-levelテクニックはあまり実装できていない。
元論文の流れは、GPUでゴリゴリにgraph partitioningするという話ではなく、
METISに渡すグラフをGPUでcoarsening → METISでinitial partitioning → GPUでuncoarsening + refinement
という話。
それを表面メッシュのラプラシアンを入力にして使いたい、という限定的なモチベーションでの実装。
こんな感じの結果が得られる。
Geometryを考慮しているわけでもないので、uniformなメッシュならきれいなpartitioningになるが、メッシュのdensityが異なる場合は見た目上のバランスが悪くなる。
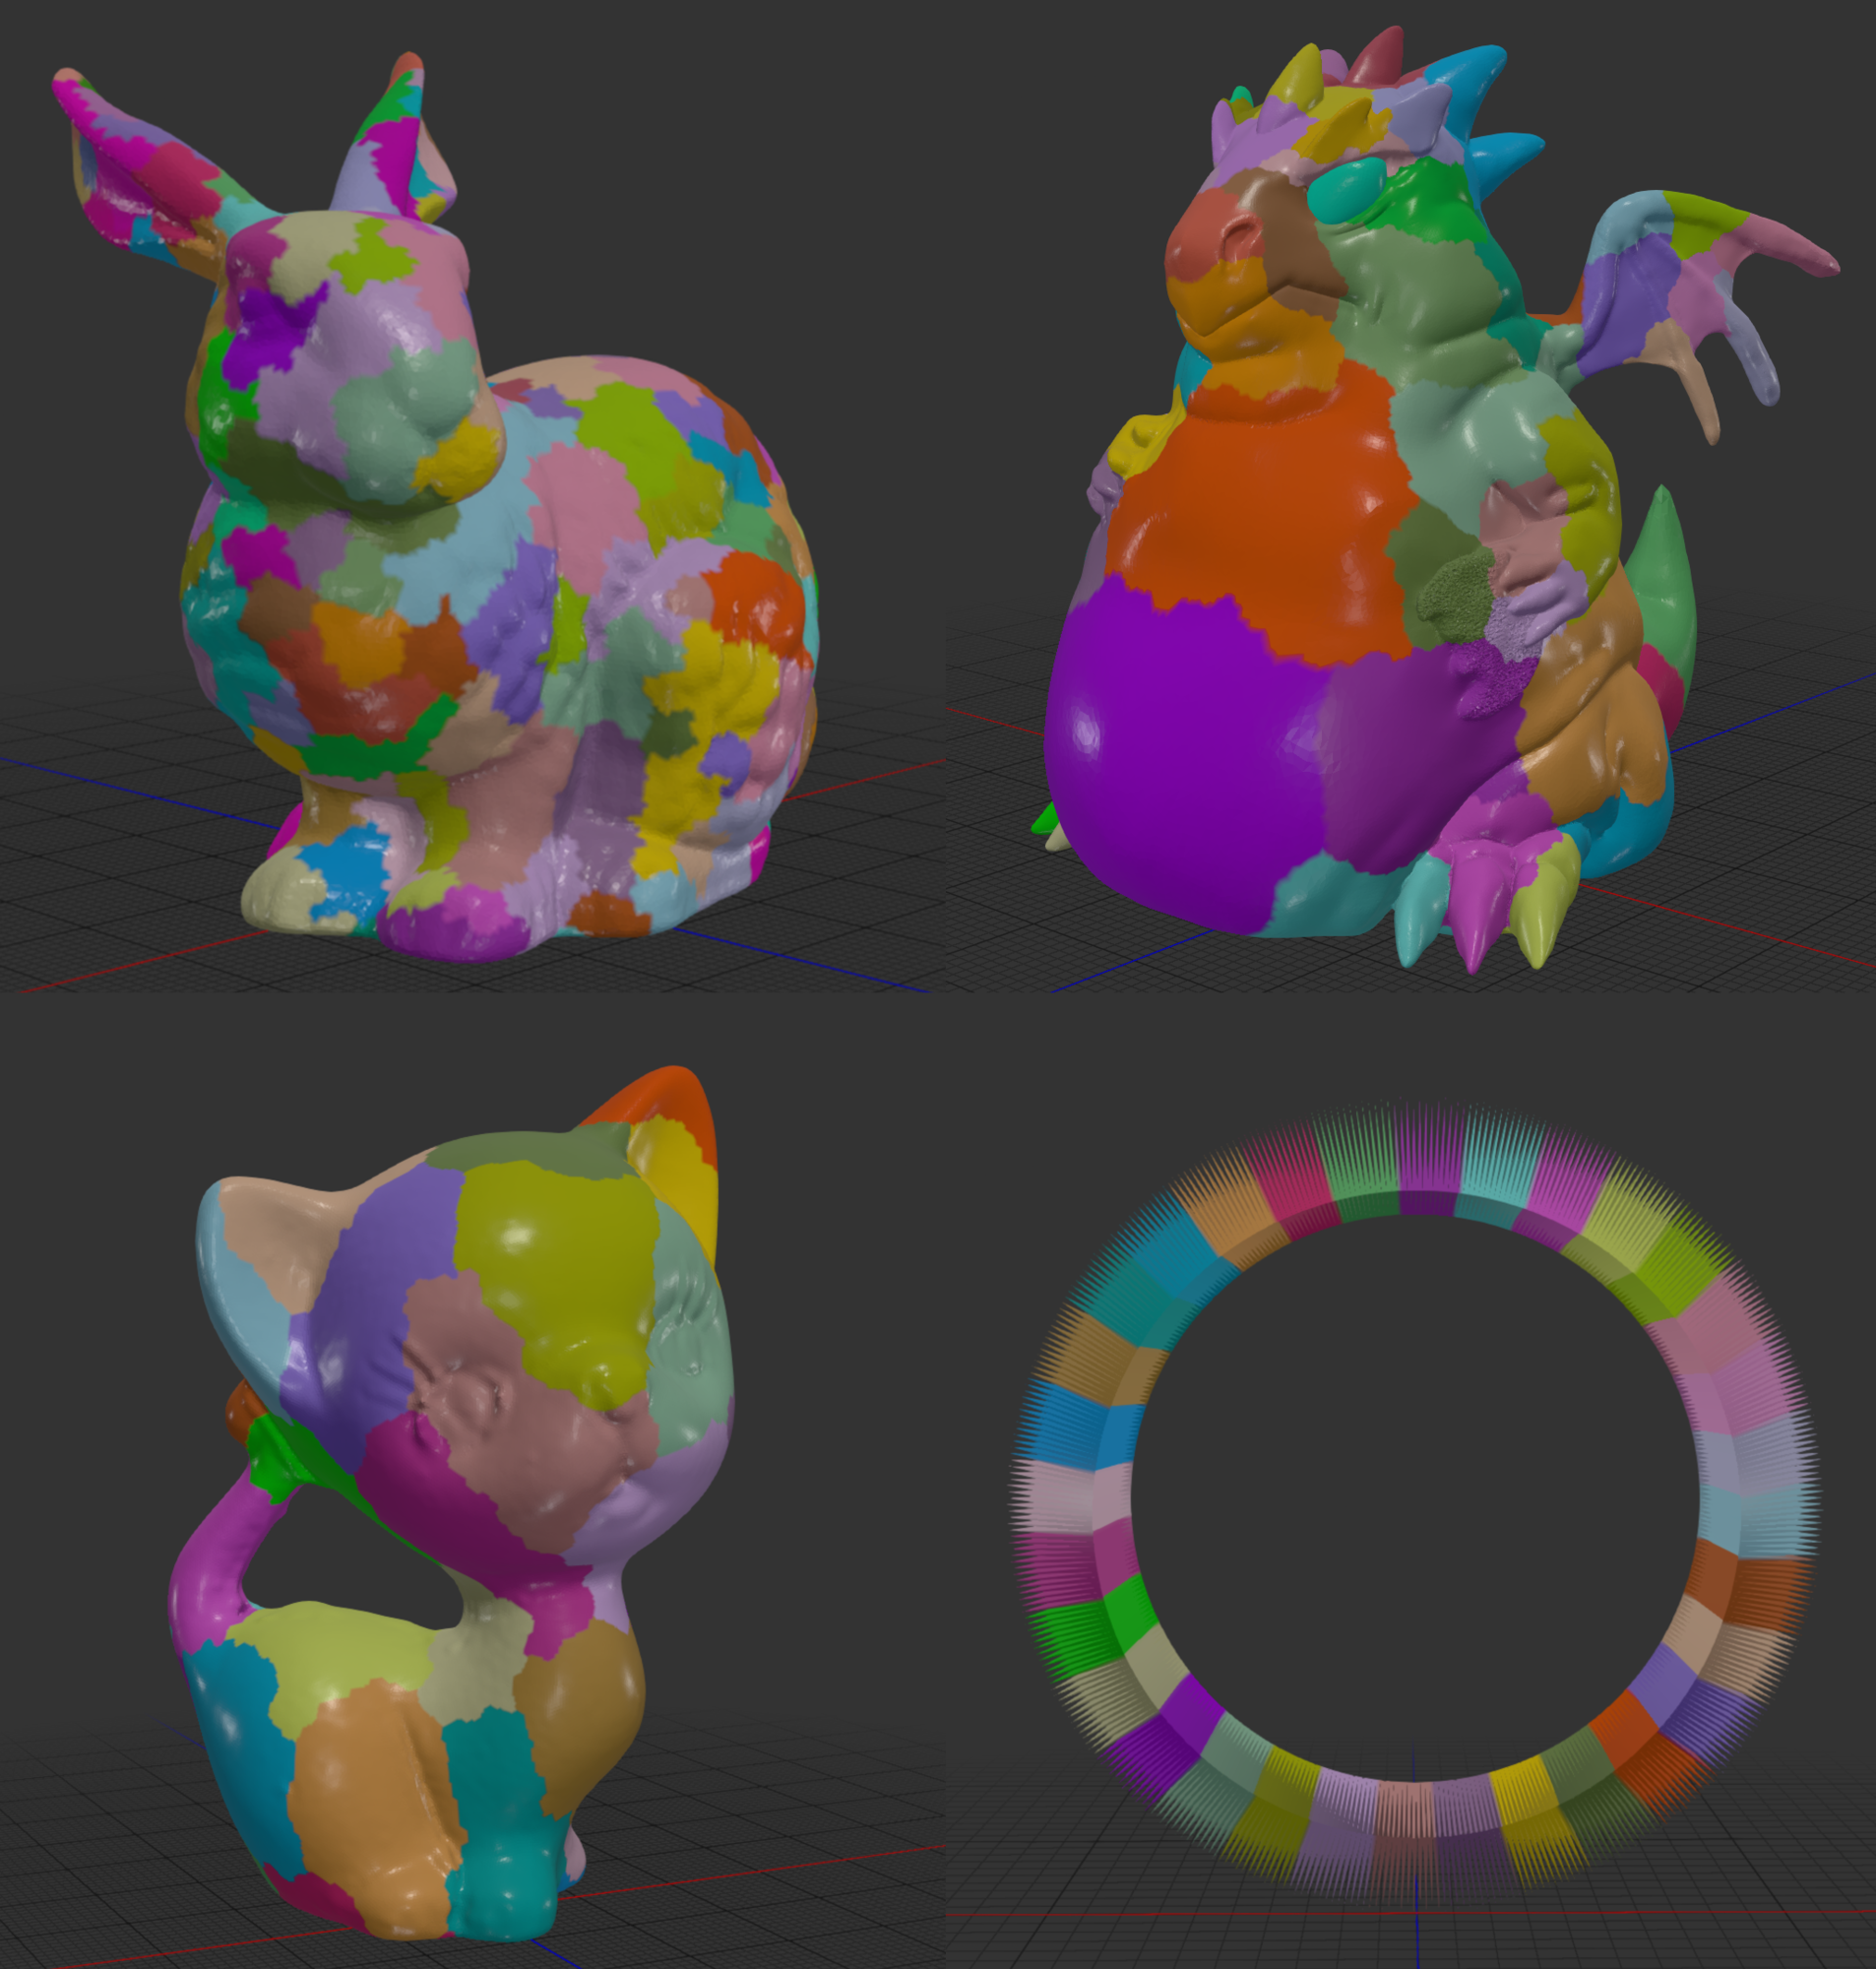
実装全体の流れは次のような感じ、
Sparse Matrix → Graph construction on GPU → GPU coarsening → CPU METIS → GPU uncoarsening + refinement → Final partition
Initialize
表面メッシュしか入力想定していないタイプの人間であるため、Eigen::SparseMatrix
Eigen::SparseMatrix
Eigen::SparseMatrix
Eigen::SparseMatrix
を利用すると割とそのままGPU-friendlyなデータが構築できる。
Per-vertex次数 → フラット隣接リストの構築という形で進む。
CPUの実装をそのままGPUにしているだけなので、次数の初期化部分だけ貼る。
template <bool IsRowMajor, unsigned int UpLo, typename StorageIndex> __global__ void computeDegreesKernel(uint32_t nv, const StorageIndex* outer, const StorageIndex* inner, uint32_t* degrees) { auto i = blockIdx.x * blockDim.x + threadIdx.x; if (i >= nv) return; StorageIndex begin = outer[i]; StorageIndex end = outer[i + 1]; for (StorageIndex j = begin; j < end; ++j) { uint32_t row = 0; uint32_t col = 0; if constexpr (IsRowMajor) { row = i; col = static_cast<uint32_t>(inner[j]); } else { row = static_cast<uint32_t>(inner[j]); col = i; } if constexpr (UpLo == Eigen::Upper) if (row >= col) continue; if constexpr (UpLo == Eigen::Lower) if (row <= col) continue; atomicAdd(°rees[row], 1u); atomicAdd(°rees[col], 1u); } }
どう考えてもrow/colのどちらかはatomicAddをループ内でやる必要はないが、面倒くさいので両方ともatomicAdd。
One-ring neighborsをthreadで処理しているため、頂点のvalenceが偏っているデータでは、特定頂点がボトルネックになる可能性がある、困った実装。
これは後続のいろいろな処理にも同じことが言える。
とはいえ、表面メッシュのvalenceは十分小さいと期待できるので、案外こちらのほうが速いことも多い(重要)。
一般的なグラフを想定するならば、warp単位でk頂点を捌く等、inactive threadが生まれにくいような丁寧な対処が必要であろう。
Coarsening
隣接する頂点から最大コストを見つける → それらをUnion-Findっぽいスタイルでまとめてcoarse graphを作成
と説明するだけなら非常にシンプル。
隣接頂点の最大コスト計算
ここはCPUの書き方をほぼそのまま持ってきた。
本論文だとwarp levelで最適化とかしてそうだったが、あんまり速く書ける自信がなかったので、愚直に。
const uint64_t base = static_cast<uint64_t>(fine.maxdeg) + 1;
Quantizer quant(fine.costs, 22u);

static __global__ void findNeighborsKernel(uint32_t nv, uint64_t base, Quantizer quant, const uint32_t* vtable,
  const uint32_t* adjacency, const double* costs, const uint32_t* degrees, uint32_t* neighbors) {

  auto u = blockIdx.x * blockDim.x + threadIdx.x;
  if (u >= nv) return;

  auto begin = vtable[u];
  auto end = vtable[u + 1];
  uint64_t score{};
  uint32_t det = Graph::invalid;

  for (auto i = begin; i < end; ++i) {
    auto v = adjacency[i];
    auto c = costs[i];
    auto d = degrees[v];

    uint64_t current = base * quant.quantize<uint32_t>(c) - d;

    if (current > score || (current == score && v < det)) {
      score = current;
      det = v;
    }
  }

  neighbors[u] = det;
}
この実装ではdoubleで直接比較せずに、わざわざ22bit幅のuint32_tでquantizeしている。 別に最小次数を選ぶtie-breakもなくして、doubleのまま比較してもよいと思う。 この後METISに渡すときに結局コストをint32_tに変換しているので、論文の雰囲気に寄せるという意味でもこうしている。
隣接頂点をまとめる
隣接頂点をまとめる操作は、CPUで書けば簡単だがGPUだと無駄に長くなる。
static __device__ uint32_t root(uint32_t* subset, uint32_t u) {
  //// benign race (maybe safe)
  // auto s = subset[u];
  // while (s != subset[s]) {
  //   s = subset[s];
  // }

  auto s = __nv_atomic_load_n(&subset[u], __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
  auto p = __nv_atomic_load_n(&subset[s], __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
  while (s != p) {
    s = p;
    p = __nv_atomic_load_n(&subset[s], __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
  }
  return s;
}

static __global__ void createSubsetKernel(uint32_t nv, const uint32_t* neighbors, uint32_t* subset, uint32_t* update) {
  auto u = blockIdx.x * blockDim.x + threadIdx.x;
  if (u >= nv) return;

  auto v = neighbors[u];
  if (v == Graph::invalid) return;

  auto s1 = root(subset, u);
  auto s2 = root(subset, v);

  if (s1 == s2) return;

  auto _s1 = atomicMin(&subset[s1], s2);
  auto _s2 = atomicMin(&subset[s2], s1);
  bool changed = _s1 > s2 || _s2 > s1;

  auto mask = __activemask();
  auto lane = threadIdx.x & 31;
  auto leader = __ffs(mask) - 1;

  if (__any_sync(mask, changed) && lane == leader) {
    __nv_atomic_store_n(update, 1u, __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
  }
}

static __global__ void compressSubsetKernel(uint32_t nv, uint32_t* subset) {
  auto u = blockIdx.x * blockDim.x + threadIdx.x;
  if (u >= nv) return;

  auto s = root(subset, u);
  __nv_atomic_store_n(&subset[u], s, __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
}

thrust::device_vector<uint32_t> subset(fine.nv());
thrust::sequence(subset.begin(), subset.end());

{
  thrust::device_vector<uint32_t> update(1, true);

  bool _update = true;
  while (_update) {
    update[0] = false;

    impl::createSubsetKernel << <grid, block >> > (
      fine.nv(),
      thrust::raw_pointer_cast(neighbors.data()),
      thrust::raw_pointer_cast(subset.data()),
      thrust::raw_pointer_cast(update.data())
      );

    impl::compressSubsetKernel << <grid, block >> > (
      fine.nv(),
      thrust::raw_pointer_cast(subset.data())
      );

    _update = update[0];
  }
}
やりたいことはシンプルで、隣接している頂点の添字が小さくなるようにunionしていく。
CPUだとrootまでたどる操作の過程でpath halvingをやったりするが、GPUだとパフォーマンスが出ていないようにみえたので、two-passで経路圧縮をしている。
GPUのUnion-Findは枯れた技術だと思うが、私はまったく知らないので、この実装はあまり効率が良くない実装だと思う。
subset変数でのdata raceを避けるために、root等ではreadのために__nv_atomic_load_n(CUDA12.8から追加されたGNU-likeな組込みatomic操作)を使ってみている。 便利。 そもそも4-byte変数のwrite/readならbenign raceを期待してもよいと思うが、普通のC++と同じで未定義動作なので、コンパイラが変なことをしないようにするためのおまじないみたいなもん。
論文にも細かいテクニックとして書いてあった、updateのチェックではatomic storeが最小限になるように、warpの代表threadだけが書き込むようにしている。 なるほどな~って感じの学びポイント。
Coarse graphの構築
上で計算したsubsetをuniqueな0~sの範囲にマップしなおす操作とか、coarse graphのedge列挙、fine graphのコストを集計、...えとせとら。
あんまり工夫ポイントがなかったので省略。
Initializeの時とは違い、edges(隣接する頂点ペアの情報)を列挙しているため、CUDA kernel的にはこちらのようなgraph構築が好ましい。
METIS
Coarse graphをMETISにお渡しする。
METISに渡すためにedgeコストをint32_tに変換するが、doubleの値を0~2r-1の範囲に収まるように量子化する。
これはMETIS内部でさらに合算されるため、割り当て幅はr=18と少なめにしている。
inline thrust::device_vector<uint32_t> partGraphMetis(const Graph& graph, const uint32_t k, const double imbalance) {
  const uint32_t nv = static_cast<uint32_t>(graph.nv());
  const uint32_t nc = static_cast<uint32_t>(graph.nc());

  thrust::host_vector<idx_t> xadj(graph.vtable.size());
  thrust::host_vector<idx_t> vwgt(nv);
  thrust::host_vector<idx_t> adjncy(nc);
  thrust::host_vector<idx_t> adjwgt(nc);

  thrust::copy(graph.vtable.begin(), graph.vtable.end(), xadj.begin());
  thrust::copy(graph.weights.begin(), graph.weights.end(), vwgt.begin());
  thrust::copy(graph.adjacency.begin(), graph.adjacency.end(), adjncy.begin());

  Quantizer quant(graph.costs, 18u);
  thrust::device_vector<idx_t> _adjwgt(nc);
  thrust::transform(graph.costs.begin(), graph.costs.end(), _adjwgt.begin(), [quant] __device__(double c) {
    return quant.quantize<idx_t>(c);
  });
  thrust::copy(_adjwgt.begin(), _adjwgt.end(), adjwgt.begin());

  idx_t nvtxs = static_cast<idx_t>(nv);
  idx_t ncon = 1;
  idx_t nparts = static_cast<idx_t>(k);
  idx_t cut = 0;

  thrust::host_vector<idx_t> part(nv, 0);

  idx_t options[METIS_NOPTIONS];
  METIS_SetDefaultOptions(options);

  options[METIS_OPTION_NUMBERING] = 0;
  options[METIS_OPTION_OBJTYPE] = METIS_OBJTYPE_CUT;

  real_t ubvec[1];
  ubvec[0] = static_cast<real_t>(1.0 + imbalance);

  int status = METIS_PartGraphKway(
    &nvtxs, &ncon, xadj.data(), adjncy.data(),
    vwgt.data(), nullptr, adjwgt.data(), &nparts,
    nullptr, ubvec, options, &cut, part.data()
  );

  if (status != METIS_OK) {
    throw std::runtime_error("METIS NG");
  }

  thrust::device_vector<uint32_t> result(nv);
  thrust::copy(part.begin(), part.end(), result.begin());

  return result;
}
Coarse-to-Fine & Refinement
METISのpartitioning結果をfine graphに戻す操作。
ただ戻すのではなく、上手にrefinementしてあげるのが定番でかつ、この論文のコア要素らしい。
かなり論文通りに実装していない自信がある。
  for (size_t level = graphs.size() - 1; level > 0; level--) {
    const auto& coarse = graphs[level];
    const auto& fine = graphs[level - 1];

    thrust::device_vector<uint32_t> finePartition(fine.nv());
    thrust::gather(coarse.f2c.begin(), coarse.f2c.begin() + fine.nv(), partition.begin(), finePartition.begin());
    partition = std::move(finePartition);

    gpart::cuda::refinePartition(partition, fine, k, imbalance, block);
  }
Refinementの流れは次のとおり。
1. 各頂点がもつedgeコストを集計して、隣接partitionのコスト総和 - 所属partitionの総和、から移動候補を作る
2. そのほか条件で候補を削る
2.1 Balance制約(あるpartitionのvertexコストが大きくなりすぎないようにする)
2.2 自分自身と隣接するある頂点が移動候補の場合、どちらか一方のみを動かす(論文では添字が小さい方だけ)
3. 移動候補を1で集計したコストをもとに順序付けし、0~m回の移動でbalance制約を満たす最大のmを見つけて移動する
みたいな感じ。
移動候補列挙
ここは二通りの実装をしており、max degree * Kが2048未満であればvertex-wise、そうでなければedge-wiseなカーネル実装をしている。 これはvertex-wiseな実装が O(|V| * max(deg) * K) になっているためであり、またedge-wise版は固定費用が大きいため(後述)である。
static __global__ void findDestinationsKernel(uint32_t nv, uint32_t k, const uint32_t* vtable, const uint32_t* adjacency, const double* costs, const uint32_t* partition,
  const uint32_t* partWeights, const uint32_t* graphWeights, const double balanceConstraint,
  thrust::pair<uint32_t, uint32_t>* destinations, double* gains, uint32_t* moves, uint32_t* movableCount) {
  // O(|V| * d * k)

  auto u = blockIdx.x * blockDim.x + threadIdx.x;
  if (u >= nv) return;

  uint32_t begin = vtable[u];
  uint32_t end = vtable[u + 1];
  uint32_t width = end - begin;
  uint32_t p1 = partition[u];

  double self = 0.0;
  uint32_t s = 0;

  for (uint32_t j = begin; j < end; ++j) {
    uint32_t v = adjacency[j];
    uint32_t p2 = partition[v];
    if (p1 == p2) {
      self += costs[j];
      ++s;
    }
  }

  if (s >= width) return;

  uint32_t dest = Graph::invalid;
  double best = 0.0;
  double w = static_cast<double>(graphWeights[u]);

  for (uint32_t p2 = 0; p2 < k; ++p2) {
    if (p1 == p2) continue;
    if (s >= width) continue;
    if ((static_cast<double>(partWeights[p2]) + w) > balanceConstraint) continue;

    double total = 0.0;
    for (uint32_t j = begin; j < end; ++j) {
      uint32_t v = adjacency[j];
      if (partition[v] == p2) {
        total += costs[j];
        ++s;
      }
    }

    double current = total - self;
    if (current > best) {
      dest = p2;
      best = current;
    }
  }

  if (dest != Graph::invalid) {
    auto n = atomicAdd(movableCount, 1u);
    destinations[n].first = u;
    destinations[n].second = dest;
    gains[n] = best;
    moves[u] = n;
  }
}
ほとんどの頂点は隣接頂点に異なるpartitionを持たない、(≠boundary)な可能性が高い。 そのためselfコスト計算のみのearly returnは非常に速度に効いた。
Edge-wiseな実装はヘビーな処理になっている。
Boundaryとなるedgeを見つける → v_idxとpartitionを抱き合わせてsort & reduceしコストを集約 → bestな移動先を見つける、といった流れ。
O(2*|E|) ではあるがradix sortやexclusive scan、定期的に挟まるGPU to CPUの同期、のおかげで一般的な表面メッシュデータではあまりパフォーマンスがよくない。
雰囲気はだいたい下のような感じ。
static __global__ void collectBoundariesKernel(uint32_t nc, int lower, const uint32_t* ctable, const uint32_t* adjacency, const double* costs, const uint32_t* partition,
  const uint32_t* partWeights, const uint32_t* graphWeights, const double balanceConstraint,
  uint64_t* boundaryPairs, double* boundaryCosts, double* selfs, uint32_t* nb) {
  auto i = blockIdx.x * blockDim.x + threadIdx.x;
  if (i >= nc) return;

  auto u = ctable[i];
  auto v = adjacency[i];
  auto c = costs[i];
  auto p1 = partition[u];
  auto p2 = partition[v];

  if (p1 == p2) {
    atomicAdd(&selfs[u], c);
    return;
  }

  if (static_cast<double>(partWeights[p2]) + static_cast<double>(graphWeights[u]) > balanceConstraint) return;

  auto n = atomicAdd(nb, 1u);
  boundaryPairs[n] = (static_cast<uint64_t>(u) << lower) | p2;
  boundaryCosts[n] = c;
}

impl::sortPairsCub(_boundaryPairs, _sortedBoundaryPairs, _boundaryCosts, _sortedBoundaryCosts, nb, upper + lower, _workspace);
impl::reduceByKeyCub(_sortedBoundaryPairs, _reduceBoundaryPairs, _sortedBoundaryCosts, _reduceBoundaryCosts, nb, _nr, _workspace);

auto keys = thrust::make_transform_iterator(
  _reduceBoundaryPairs.begin(), [lower] __device__(uint64_t value) -> uint32_t {
  return static_cast<uint32_t>(value >> lower);
});
impl::reduceByKeyCub(keys, _uniqueVertex, ones, _uniqueVcount, nr, _nu, _workspace);
impl::exclusiveScanCub(_uniqueVcount, _uniqueVbegin, nu, _workspace);

static __global__ void findDestinationsKernel(uint32_t nu, int lower, const uint32_t* vertex, const uint32_t* vbegin, const uint32_t* vcount,
  const uint64_t* boundaryPairs, const double* boundaryCosts, const double* selfs,
  thrust::pair<uint32_t, uint32_t>* destinations, double* gains, uint32_t* moves, uint32_t* movableCount) {
  // O(2|E|)

  auto i = blockIdx.x * blockDim.x + threadIdx.x;
  if (i >= nu) return;

  uint32_t u = vertex[i];
  uint32_t begin = vbegin[i];
  uint32_t end = begin + vcount[i];

  double self = selfs[u];
  uint32_t dest = Graph::invalid;
  double best = 0.0;

  for (uint32_t j = begin; j < end; ++j) {
    uint64_t vp = boundaryPairs[j];
    double gain = boundaryCosts[j] - self;
    if (gain > best) {
      dest = static_cast<uint32_t>(vp & ((1 << lower) - 1));
      best = gain;
    }
  }

  if (dest != Graph::invalid) {
    auto n = atomicAdd(movableCount, 1u);
    destinations[n].first = u;
    destinations[n].second = dest;
    gains[n] = best;
    moves[u] = n;
  }
}
さて、両実装ともループのたびにゼロからboundaryチェックをしているが、実際のところ移動した頂点とその周辺のコストだけを更新すればよいので、最適化余地はあるように思える。 ただしその場合、balance制約を満たすlegalな頂点かどうかのチェックが邪魔になる可能性はある。 結局これは後続の処理でもう一度確認するので、正味不要説はある。
隣接候補の除去とsort
シンプルに隣接頂点が移動同士なら添字が大きいほうを除去していく。
ここでわざわざ移動数の総数をカウントダウンせず、余分なものには無効な値をいれてsortで後ろ側に落とす、という安い操作で済ませている。
また論文と合わせて、一度の移動では最大1024頂点までとしている。
static __global__ void discardAdjacentMoveKernel(uint32_t nc, const uint32_t* ctable, const uint32_t* adjacency,
  const uint32_t* moves, thrust::pair<uint32_t, uint32_t>* destinations, double* gains) {

  auto i = blockIdx.x * blockDim.x + threadIdx.x;
  if (i >= nc) return;

  auto u = ctable[i];
  auto v = adjacency[i];

  auto m1 = moves[u];
  auto m2 = moves[v];

  bool movable1 = (m1 != Graph::invalid);
  bool movable2 = (m2 != Graph::invalid);

  if (movable1 && movable2) {
    constexpr double neg = Graph::negative;
    if (u > v) {
      __nv_atomic_store_n(&destinations[m1].first, Graph::invalid, __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
      __nv_atomic_store_n(&destinations[m1].second, Graph::invalid, __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
      __nv_atomic_store(&gains[m1], &neg, __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
    } else {
      __nv_atomic_store_n(&destinations[m2].first, Graph::invalid, __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
      __nv_atomic_store_n(&destinations[m2].second, Graph::invalid, __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
      __nv_atomic_store(&gains[m2], &neg, __NV_ATOMIC_RELAXED, __NV_THREAD_SCOPE_DEVICE);
    }
  }
}

thrust::sort_by_key(gains.begin(), gains.begin() + movableCount, destinations.begin(), ::cuda::std::greater<double>{});
movableCount = std::min(limit, movableCount);
移動
移動幅の計算と移動後のコスト更新を担うところ。
元論文ではなんか色々工夫されていた記憶があるが、割と愚直に実装している。
というのも、移動先を見つける処理のほうが圧倒的に重いので、あまり頑張っていない。
bool moved = false;

{
  const uint32_t nkmv = k * movableCount;
  // collect plus deltas and minus deltas for each partition
  {
    const thrust::pair<uint32_t, uint32_t>* _mvs = thrust::raw_pointer_cast(destinations.data());
    const uint32_t* _ps = thrust::raw_pointer_cast(partition.data());
    const uint32_t* _ws = thrust::raw_pointer_cast(graph.weights.data());

    auto key = [movableCount] __device__(uint32_t i) -> uint32_t { return i / movableCount; };
    auto kbegin = thrust::make_transform_iterator(thrust::counting_iterator<uint32_t>(0), key);

    auto value = [_mvs, _ps, _ws, movableCount] __device__(uint32_t i) -> thrust::pair<uint32_t, uint32_t> {
      uint32_t p = i / movableCount;
      uint32_t s = i % movableCount;

      auto u = _mvs[s].first;
      auto trg = _mvs[s].second;
      if (u == Graph::invalid || trg == Graph::invalid) return thrust::make_pair(0u, 0u);

      auto src = _ps[u];
      auto w = _ws[u];

      uint32_t minus = 0u;
      uint32_t plus = 0u;

      if (p == src) minus = w;
      if (p == trg) plus = w;

      return thrust::make_pair(minus, plus);
    };
    auto vbegin = thrust::make_transform_iterator(thrust::counting_iterator<uint32_t>(0), value);

    thrust::inclusive_scan_by_key(
      kbegin, kbegin + nkmv, vbegin, deltas.begin(),
      ::cuda::std::equal_to<uint32_t>(),
      [] __device__(const auto& a, const auto& b) {
      return thrust::make_pair(a.first + b.first, a.second + b.second);
    }
    );
  }

  // compute weights and legality for each move prefix
  // find the longest prefix s.t. all partition weights are less than balanceConstraint
  uint32_t rangeCount = 0;
  {
    cudaMemset(thrust::raw_pointer_cast(_rangeCount.data()), 0, sizeof(uint32_t));

    uint32_t* _ws = thrust::raw_pointer_cast(moveWeights.data());
    const uint32_t* _pws = thrust::raw_pointer_cast(partWeights.data());
    const thrust::pair<uint32_t, uint32_t>* _ds = thrust::raw_pointer_cast(deltas.data());
    uint32_t* _r = thrust::raw_pointer_cast(_rangeCount.data());

    thrust::for_each_n(thrust::counting_iterator<uint32_t>(0), movableCount,
      [_ws, _pws, _ds, _r, movableCount, k, balanceConstraint] __device__(uint32_t s) {
      uint8_t legal = 1u;

      for (uint32_t p = 0; p < k; ++p) {
        uint32_t i = p * movableCount + s;
        uint64_t w = static_cast<uint64_t>(_pws[p]) + static_cast<uint64_t>(_ds[i].second) - static_cast<uint64_t>(_ds[i].first);
        _ws[i] = static_cast<uint32_t>(w);

        if (w > balanceConstraint) {
          legal = 0u;
          break;
        }
      }

      if (legal != 0u) {
        atomicMax(_r, s + 1u);
      }
    }
    );

    rangeCount = _rangeCount[0];
  }

  if (rangeCount > 0) {
    moved = true;
    {
      uint32_t* _ps = thrust::raw_pointer_cast(partition.data());
      const thrust::pair<uint32_t, uint32_t>* _mvs = thrust::raw_pointer_cast(destinations.data());

      thrust::for_each_n(thrust::counting_iterator<uint32_t>(0), rangeCount,
        [_ps, _mvs] __device__(uint32_t i) {
        auto u = _mvs[i].first;
        auto trg = _mvs[i].second;
        if (u == Graph::invalid || trg == Graph::invalid) return;
        _ps[u] = trg;
      }
      );
    }
    {
      uint32_t* _pws = thrust::raw_pointer_cast(partWeights.data());
      const uint32_t* _ws = thrust::raw_pointer_cast(moveWeights.data());

      thrust::for_each_n(thrust::counting_iterator<uint32_t>(0), k,
        [_pws, _ws, movableCount, rangeCount] __device__(uint32_t p) {
        _pws[p] = _ws[p * movableCount + rangeCount - 1u];
      }
      );
    }
  }
}

if (!moved) break;
Warp単位での最適化みたいなことはしていないが、partition数*move数の操作になるよう、フラットに計算している(最低限の努力)。 移動可能数(movableCountやrangeCount)はたいてい非常に小さい数なので、小さい固定コストのほうが厳しい気がする。
ザックリとした速度計測。
CPU実装も書いてみたが、あくまで論文実装するときのプロトタイプコードなので速度については期待していない。 当たり前だが、METISを直接呼んだときのほう(METIS内部のcoarseningのほう)が圧倒的に早いと思う。
Officialの実装っぽいライセンス不明のリポジトリがあったので、それとも一応比較しておく。
GitHub - wanluanlee/DAC_g-kway · GitHub
コードの中身とか一切見ていないので、使い方間違っていたかもしれない。
そもそも入力形式が違うのでトータル時間の計測はしていない(公式版はファイルI/O挟まるので比較にならない)。
あと公式版はpartition数=Kを大きくすると(100以上)、クラッシュしていたので一部比較不可だった。
CUDA Kernelのblock sizeはすべて128で実行。 すべて何回かwarm-upしてからの記録なので、参考値って感じ、計測ブレは大きいと思う。 GPUが冷えてる時だとInitあたりでテーブルの5~6倍遅い数字出したりしていた。
AMD Ryzen 7 7700 8-Core
NVIDIA GeForce RTX 5060 Ti
Kitten from AIM@Shape
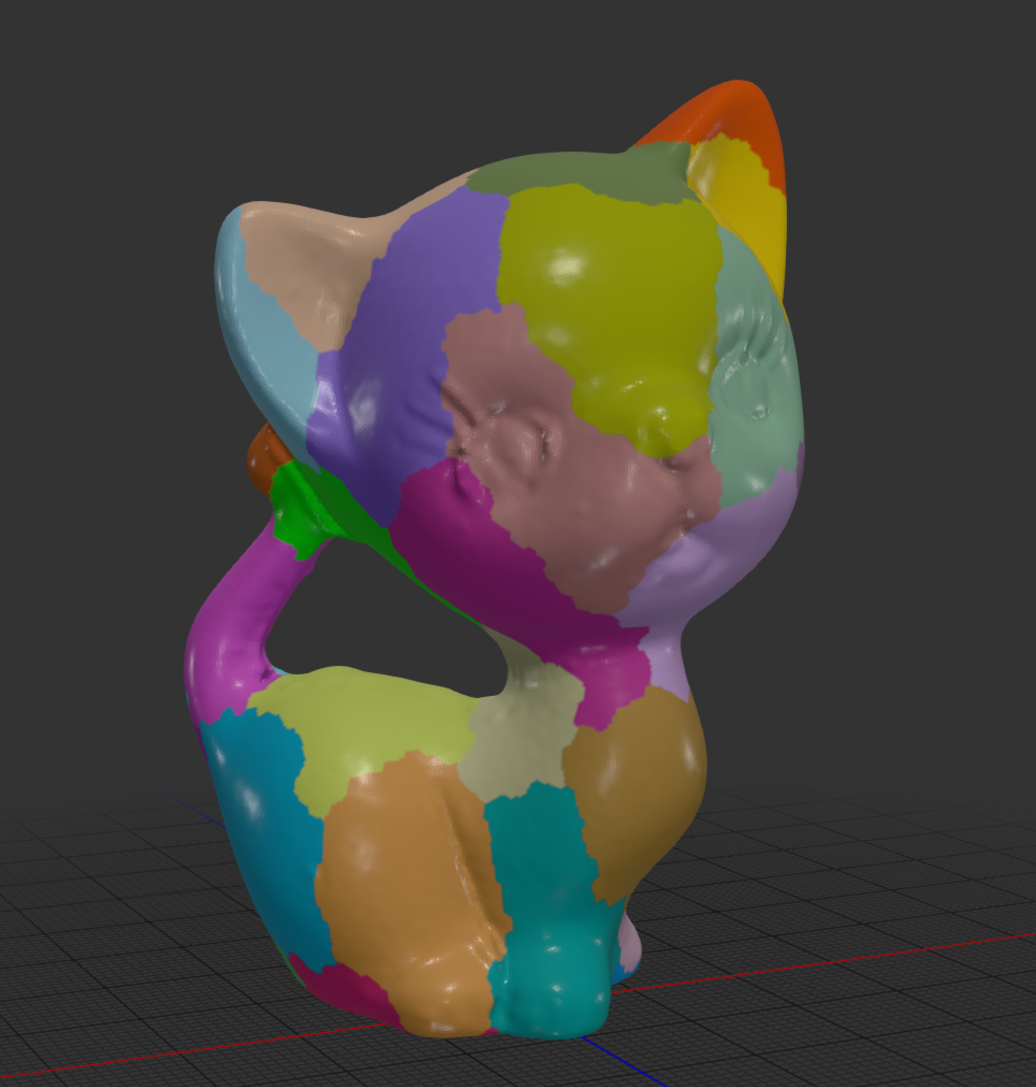
|V| = 134448, |F| = 268896, Max Deg. = 8, K = 16, Imbalance=0.1
METIS生呼び:32ms
| Coarse | Refine | Init | Total | |
|---|---|---|---|---|
| CPU | 24 ms | 41 ms | 4 ms | 75 ms |
| GPU | 7 ms | 8 ms | 3 ms | 23 ms |
| Official | 37 ms | 10 ms | N/A | 52 ms (w/o I/O) |
Dragon from Thingi10K
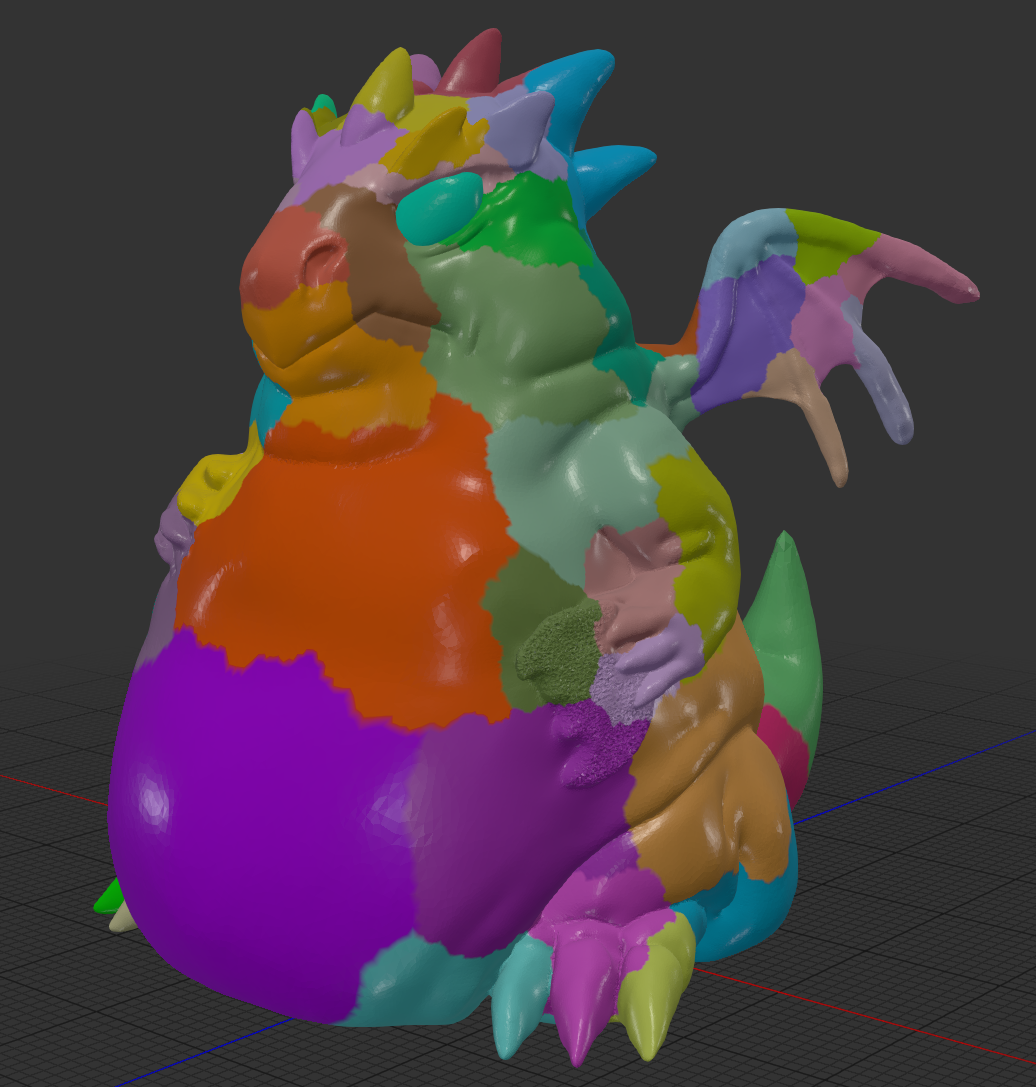
|V| = 484766, |F| = 969520, Max Deg. = 17, K = 64, Imbalance=0.1
METIS生呼び:177ms
| Coarse | Refine | Init | Total | |
|---|---|---|---|---|
| CPU | 136 ms | 410 ms | 21 ms | 583 ms |
| GPU | 15 ms | 19 ms | 9 ms | 61 ms |
| Official | 29 ms | 16 ms | N/A | 64 ms (w/o I/O) |
Bunny (remesh) from The Stanford Models
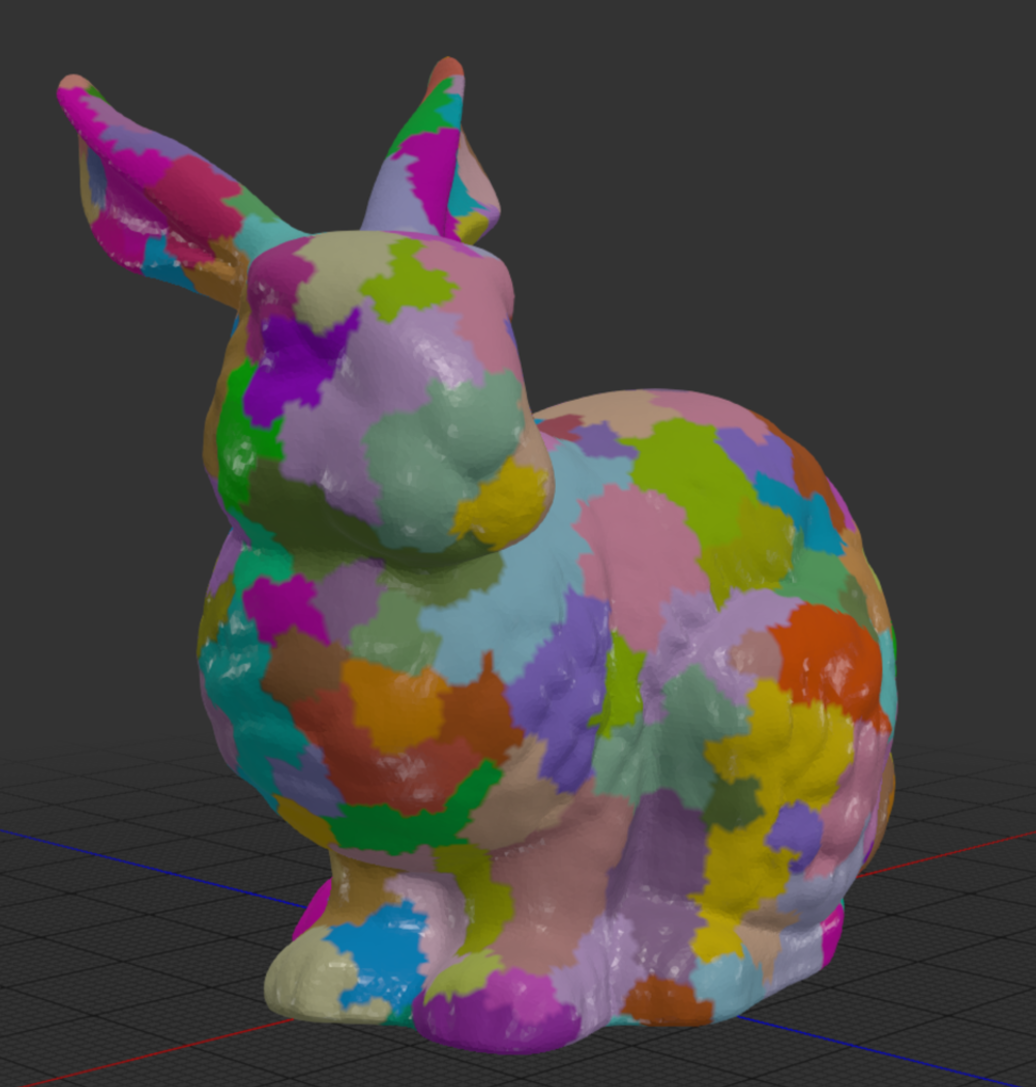
|V| = 72023, |F| = 144042, Max Deg. = 10, K = 256, Imbalance=0.1
METIS生呼び:89ms
| Coarse | Refine | Init | Total | |
|---|---|---|---|---|
| CPU | 16 ms | 24 ms | 4 ms | 55 ms |
| GPU | 6 ms | 6 ms | 2 ms | 24 ms |
| Official | N/A | N/A | N/A | N/A |
Armadillo (subdivision) from The Stanford Models
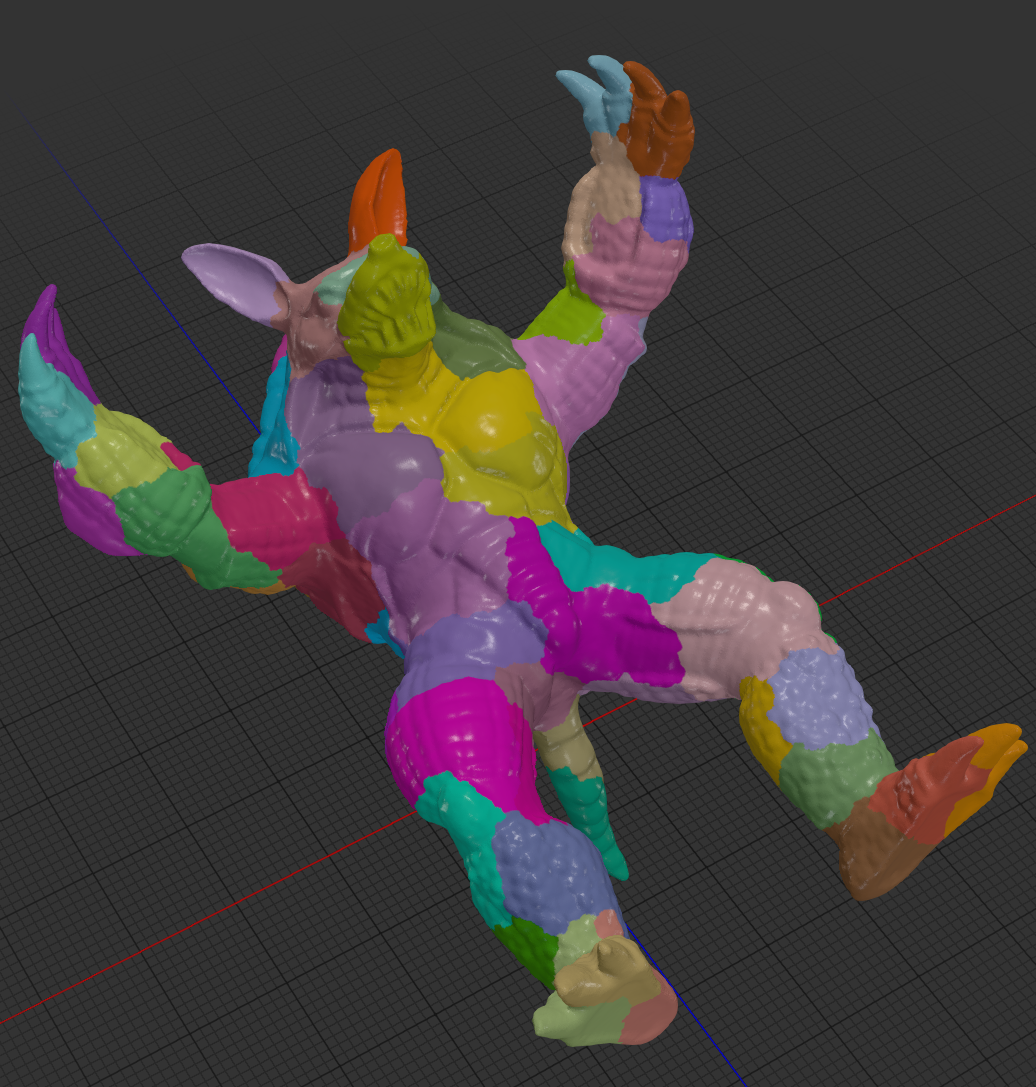
|V| = 1037834, |F| = 2075664, Max Deg. = 14, K = 32, Imbalance=0.1
METIS生呼び:347ms
| Coarse | Refine | Init | Total | |
|---|---|---|---|---|
| CPU | 246 ms | 577 ms | 68 ms | 903 ms |
| GPU | 20 ms | 21 ms | 20 ms | 73 ms |
| Official | 39 ms | 15 ms | N/A | 65 ms (w/o I/O) |
Large Valence
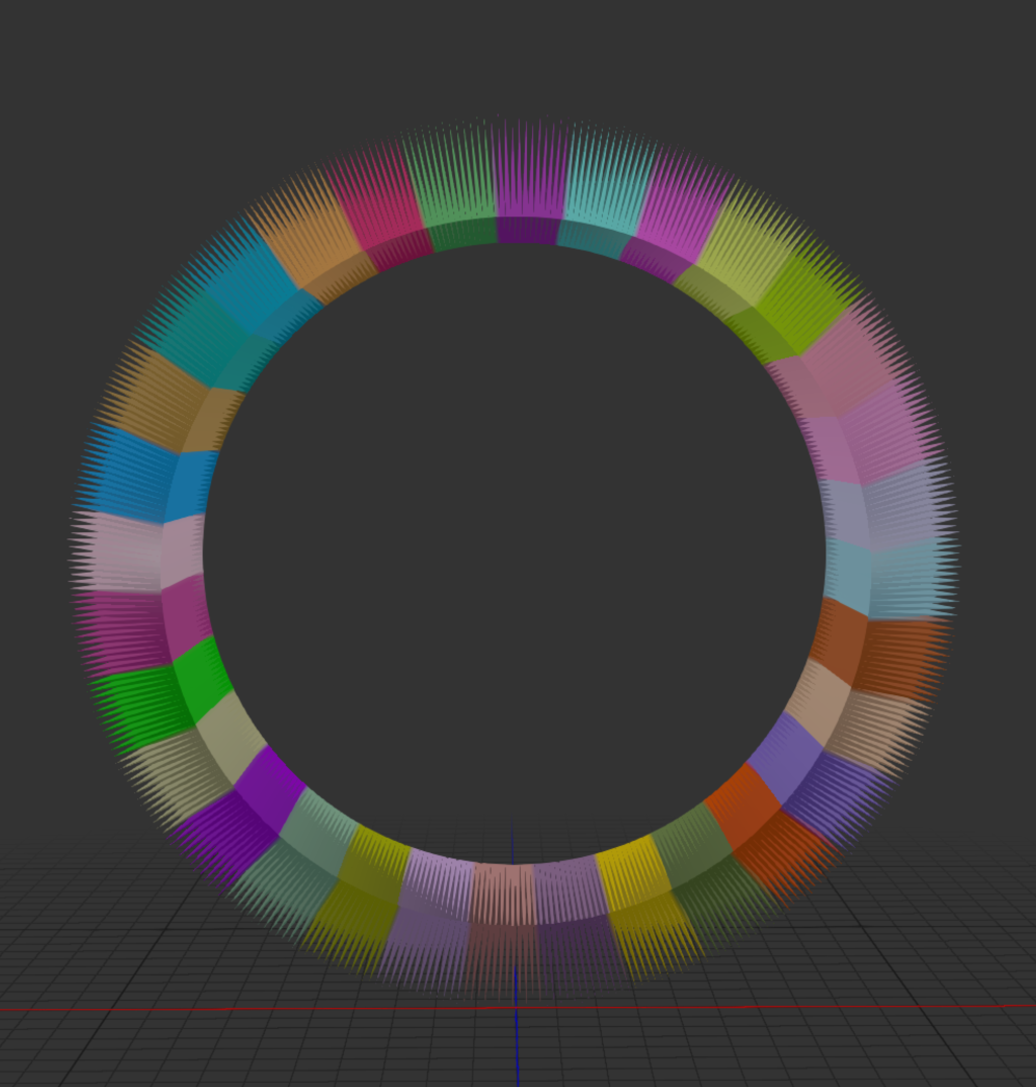
|V| = 2000400, |F| = 4000002, Max Deg. = 10000, K = 32, Imbalance=0.1
METIS生呼び:244ms
| Coarse | Refine | Init | Total | |
|---|---|---|---|---|
| CPU | 131 ms | 175 ms | 49 ms | 363 ms |
| GPU | 22 ms | 16 ms | 45 ms | 93 ms |
| Official | 715 ms | 19 ms | N/A | 741 ms (w/o I/O) |
うーん、どうなんだろう。
一回限りの操作として見ると、CUDAの固定コストが重くて速度アップが体感しにくかった(上述のとおりGPUが温まってないとInit*6倍くらいの+time)。
このpartitioningの前後でgraph系の何らかの操作をGPU上でやる場合は、数倍以上高速化できているとみてもいいのかな。
Coarse+Refineだけならちゃんと速いといっていいと思う。
また、少なくとも一般的な表面メッシュのラプラシアンを入力とした場合、公式実装とだいぶ張り合っているというか、そこまで爆速って感じではなかった。
特にcoarseningの部分は公式版の実装はなにか悪い気もする(Large Valenceの結果)。
中身見てないので知らないが。
というかMETISが割と高速なことを知った。
応用先を考えてないのでedge cutの品質が良いとか悪いとかは今後考える。
いい感じに高速なグラフ分割手法を手に入れた、と思う。 当初の想定よりもMETIS依存だし、なんならMETIS単品もなかなか高速だったわけだが、それもまた気づき。
CUDAでのUnion-Find実装がちょっと勉強したくなってきたかも。
ある意味改めて初歩的なアルゴリズムとデータ構造を見直すきっかけになった。
いやはや。
知識は深海よりも海、潜れど潜れど、気づけば浅瀬に押し戻されている。
